세 줄 요약
- 9월 1일 페이블 5.1, 9월 4일 GPT-6. 사흘 간격이고 두 회사 차트 가로축이 나란히 API 비용으로 바뀌었습니다.
- 그런데 저희가 같은 과제를 네 모델에 시켜보니 제일 비싼 게 제일 느렸고 답은 그 아래 등급과 같았습니다.
- 갈리는 건 모델이 아니라 정답 세트가 있느냐입니다. 저희 게시 전 검사 11종 중 AI를 쓰는 건 0개예요.
9월 1일 클로드 페이블 5.1, 9월 4일 GPT-6 Astra. 사흘 간격입니다.
이 속도면 다음 달에도 또 나옵니다. 그때마다 물어야 할 게 있어요. "어느 게 더 센가"가 아니라 "매번 비싼 걸 살 건가"입니다.
두 회사가 이미 답을 바꿨습니다
이번 발표에서 제 눈을 붙든 건 점수가 아니라 차트의 가로축이었습니다.
OpenAI는 대표 차트 가로축에 API 비용을 놨습니다. 세로가 성능, 가로가 값이에요. 앤트로픽도 같은 말을 합니다 — "낮은 노력 설정으로 이전 세대와 비슷하거나 더 나은 결과를 훨씬 낮은 비용에".
작년 차트엔 값 축이 없었습니다.
OpenAI가 자랑한 문장도 그렇습니다. 터미널 코딩에서 57.9% 대 55.8%, 2점 차. 그런데 자랑하는 건 2점이 아니라 "API 비용 63% 낮음"입니다.
두 회사가 지금 파는 건 성능이 아니라 성능÷값입니다. 이 흐름이 계속되면 좋은 모델은 계속 싸집니다.
이런 소식, 남들보다 먼저 받으실 분?
직접 돌려보고 되는 것만 골라 매주 보내드립니다. 광고성 하이프는 거릅니다.
같은 자로 잰 칸은 넷 — 3 대 1입니다
두 회사 발표문에서 시험 이름과 버전이 정확히 같은 칸만 뽑았습니다.
| 무슨 시험인가 | GPT-6 Astra | 페이블 5.1 |
|---|---|---|
| 터미널 코딩 (Terminal-Bench 4.0) | 57.9% | 55.8% |
| 과학 연구 (Terminal-Bench Science 0.1) | 64.6% | 52.6% |
| 전문 지식 (GPQA Diamond) | 96.0% | 93.7% |
| 도구 쓰는 추론 (Humanity's Last Exam) | 57.2% | 65.0% |
마지막 줄은 OpenAI 발표문 안에 있습니다. 자기 자료에 남이 이긴 숫자를 지우지 않았어요.
그리고 터미널 코딩 1위는 둘 다 아닙니다. 같은 시험에서 클로드 미토스 5.1이 60.9%로 제일 높습니다. 앤트로픽 표를 끝까지 보면 나옵니다.
⚠ 컴퓨터 조작(OSWorld 2.0)은 비교하면 안 됩니다. OpenAI는 지연시간을 흉내 낸 조건에서 72.6%, 앤트로픽은 채점 기준을 나눠 77.9%(partial)·41.7%(strict)로 발표했습니다. 이름은 같은데 잰 방식이 달라요. 이 칸을 그냥 붙여놓은 비교 글이 있으면 거기서 거르시면 됩니다.
이 글의 숫자는 전부 OpenAI 발표문과 앤트로픽 발표문 원문에서 직접 가져왔습니다. 저희는 GPT-6를 아직 안 돌려봤습니다 — 돌려보면 그때 실측으로 다시 쓰겠습니다.
그런데 저희 실측은 반대를 가리켰습니다
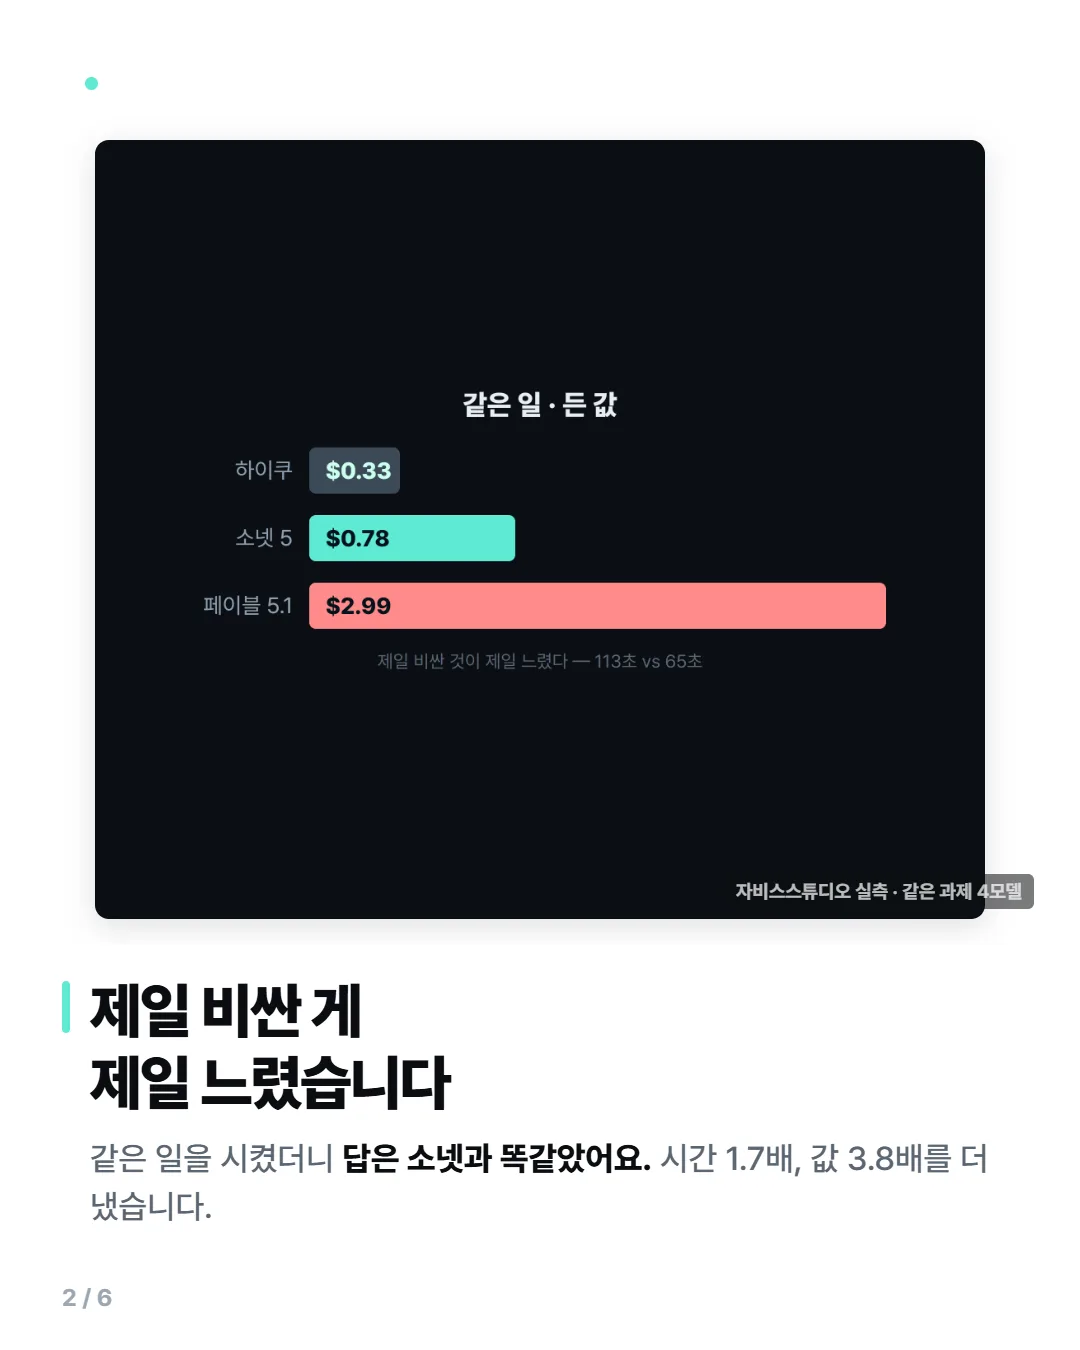
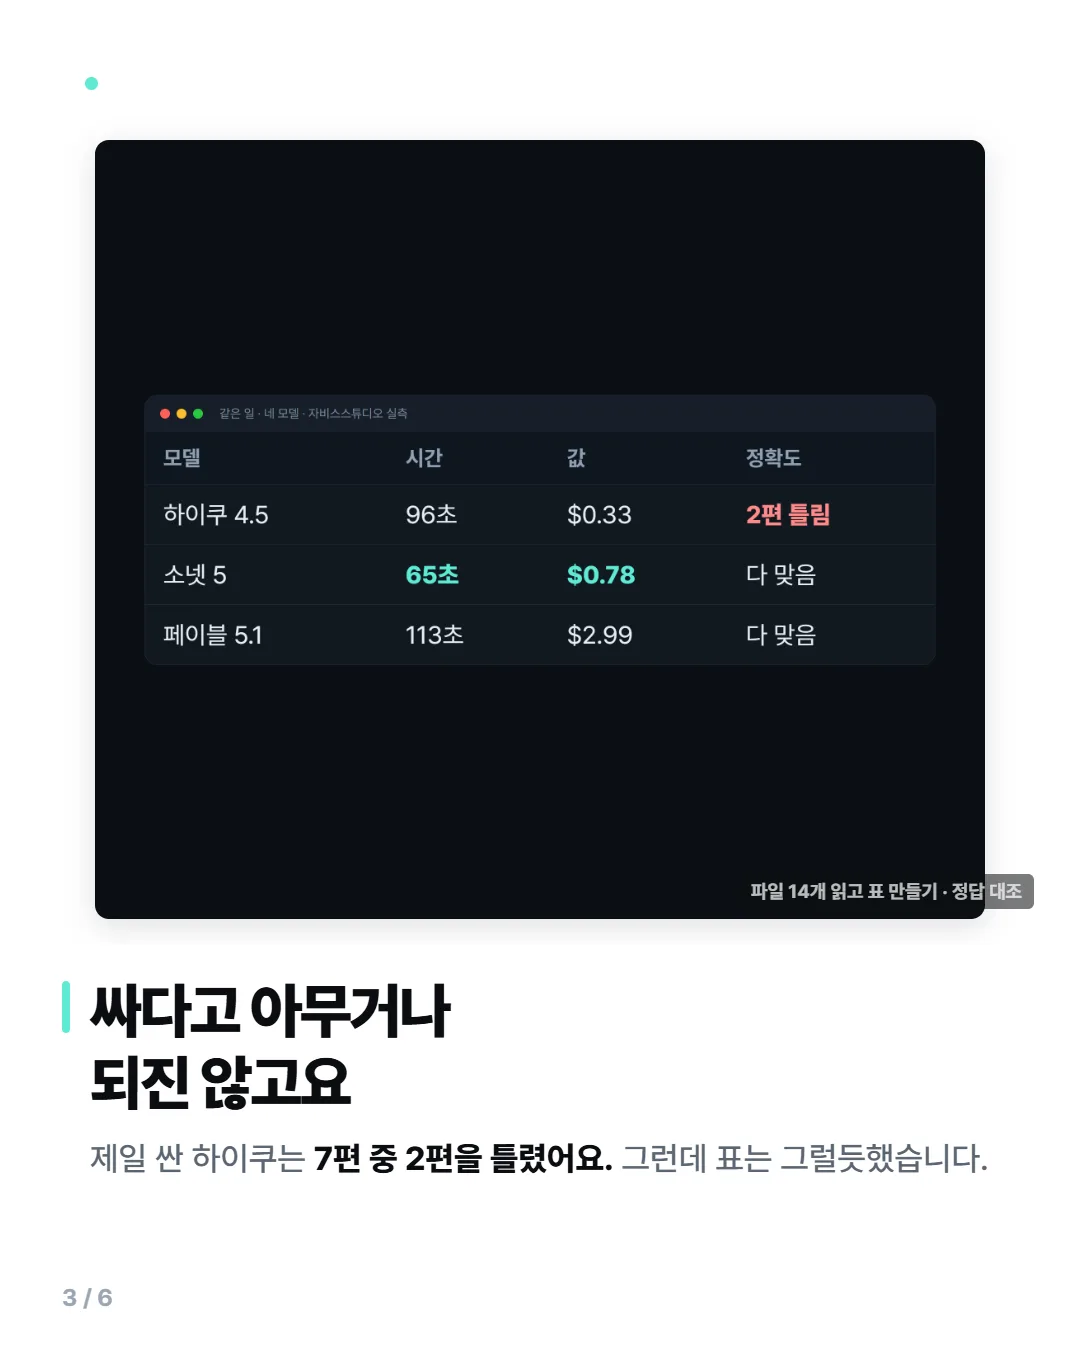
지난주 페이블 5.1이 나왔을 때 저희가 매주 하는 일을 네 모델에 똑같이 시켰습니다. 글 7편의 파일 14개를 읽고 표로 정리하는 일이에요.
| 모델 | 걸린 시간 | 든 값 | 정확도 |
|---|---|---|---|
| 하이쿠 4.5 | 96초 | $0.33 | 7편 중 2편 틀림 |
| 소넷 5 | 65초 | $0.78 | 다 맞음 |
| 페이블 5.1 | 113초 | $2.99 | 다 맞음 |
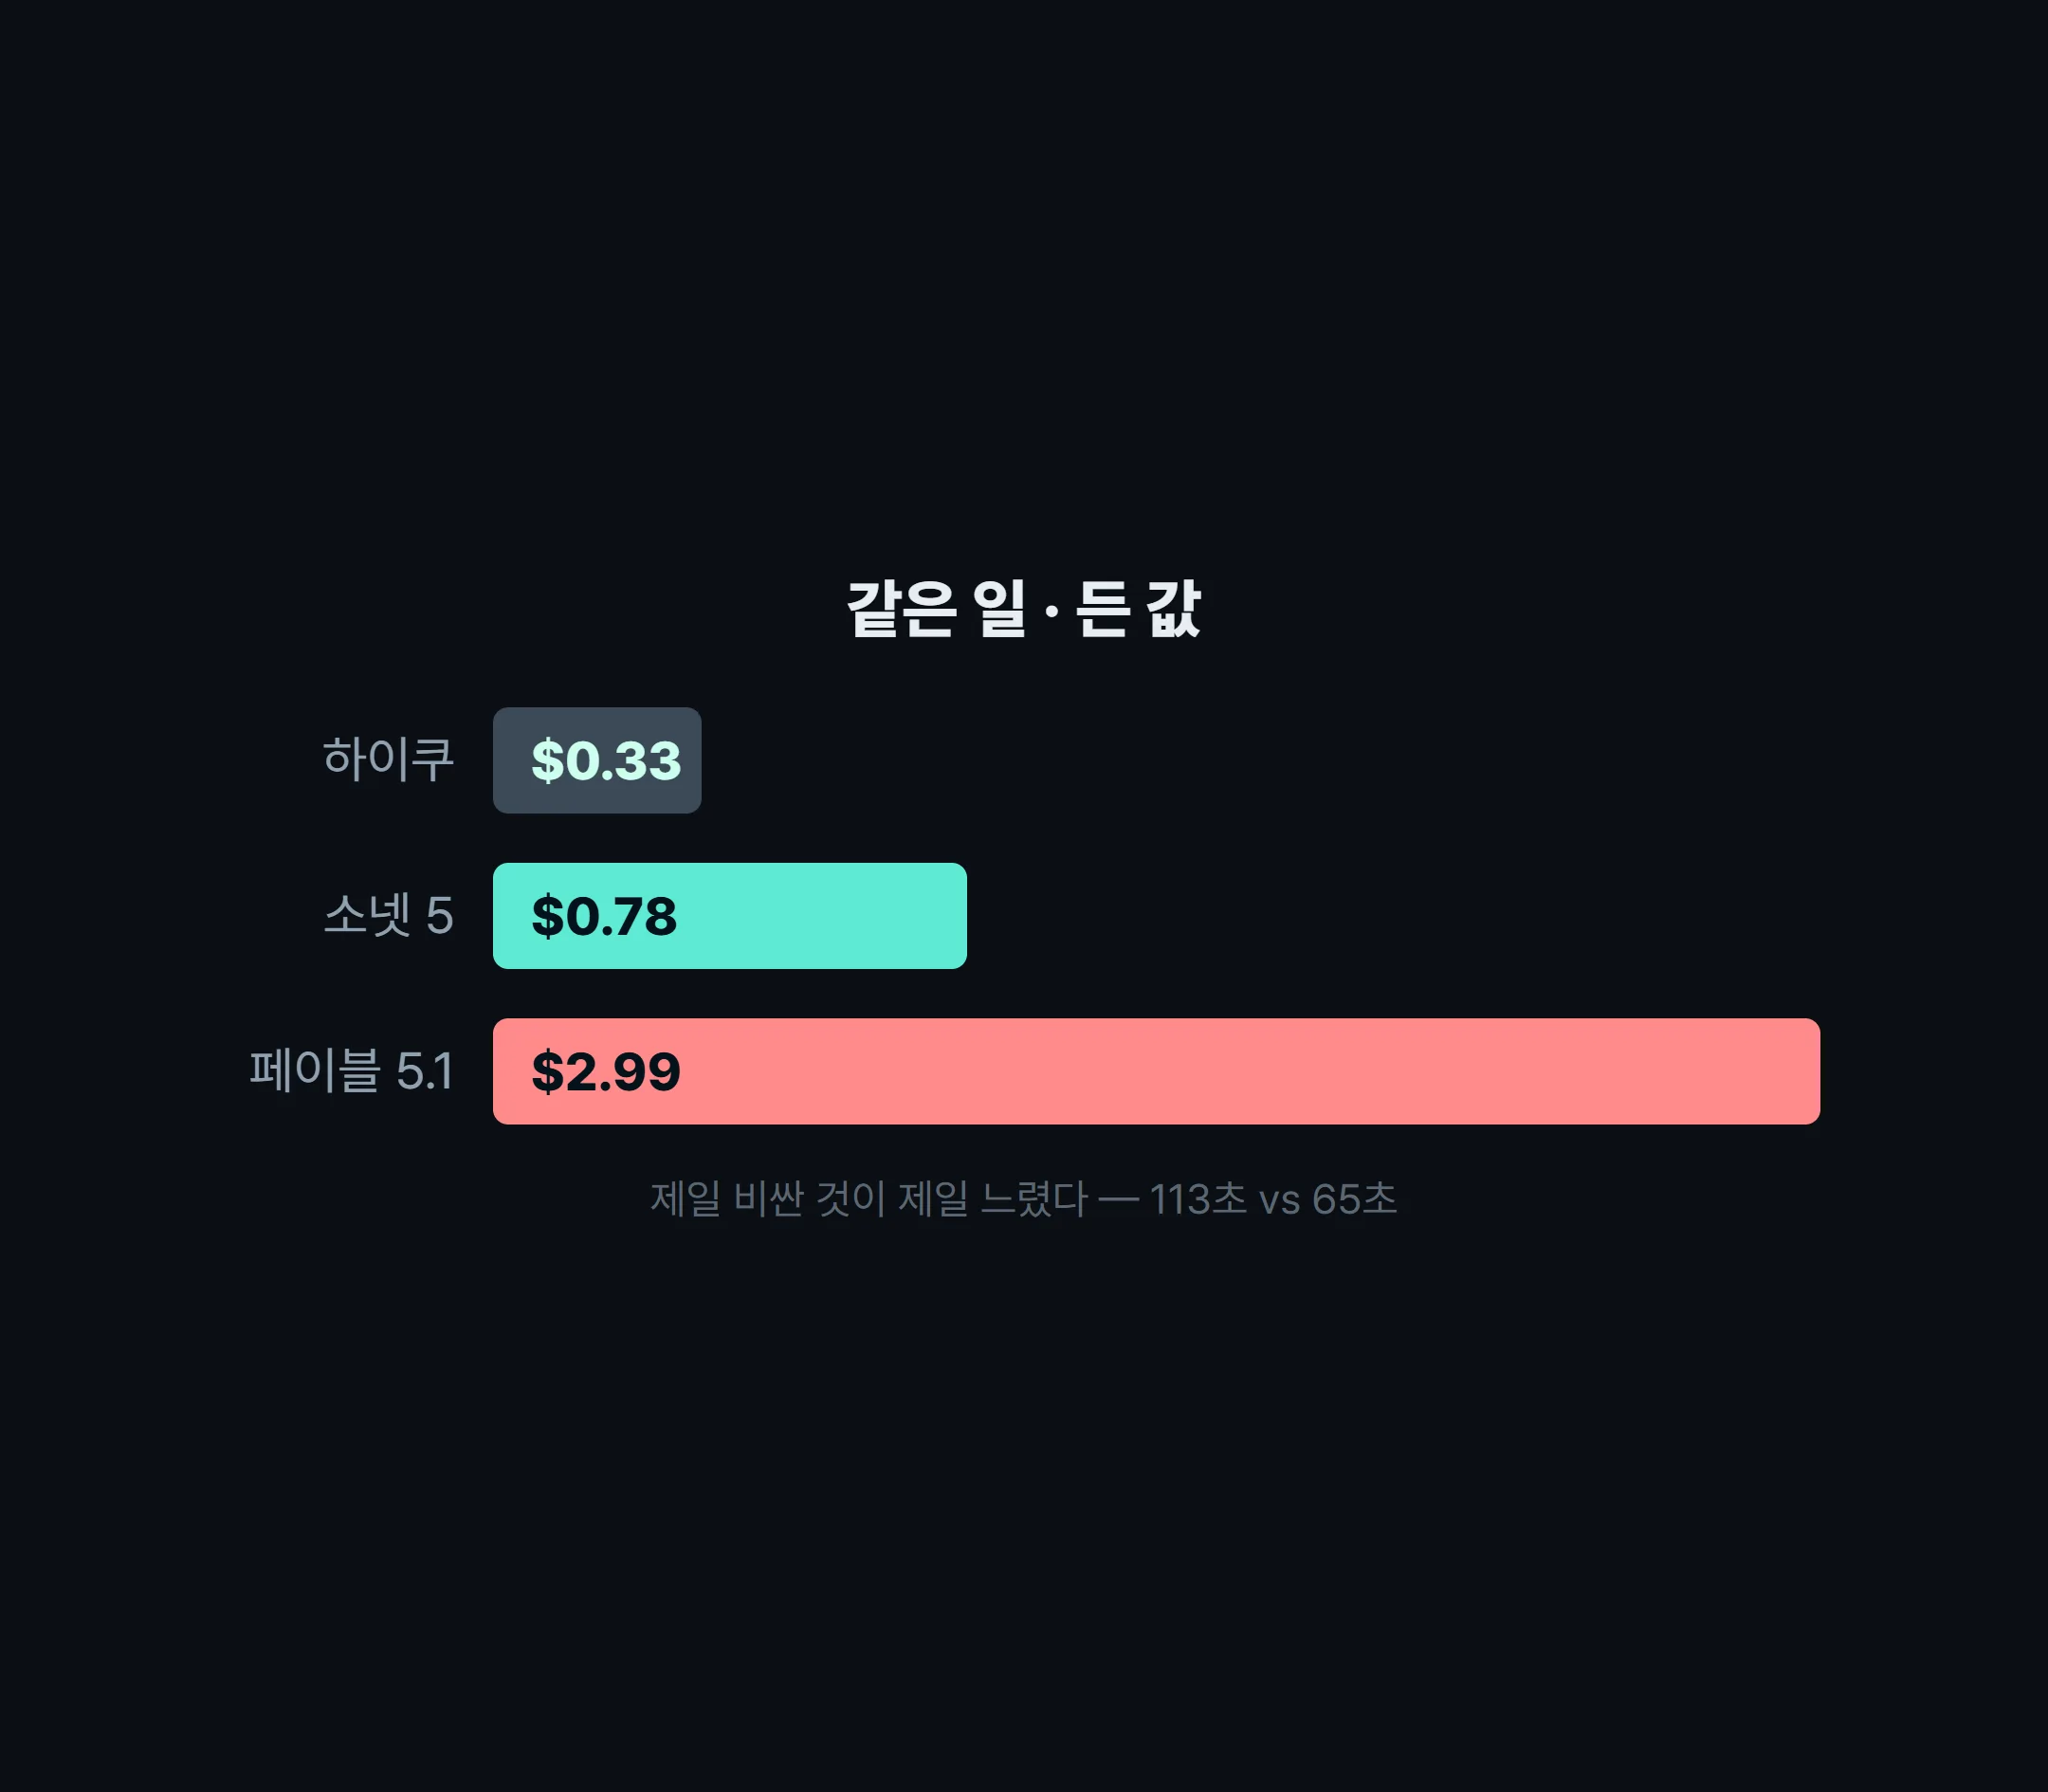
제일 비싼 게 제일 느렸고, 답은 소넷과 같았습니다.
왜 느렸는지도 봤습니다. 오퍼스는 파일을 6번에 묶어 읽었는데 페이블은 21번에 나눠 읽었어요. 생각 깊이를 낮춰도 8% 빨라지는 정도였습니다. 병목이 지능이 아니라 왕복이었습니다.
그렇다고 제일 싼 걸로 내리면 되냐 — 아니었습니다. 하이쿠는 카드가 10장인데 11장이라고 했어요. 표는 그럴듯했습니다.
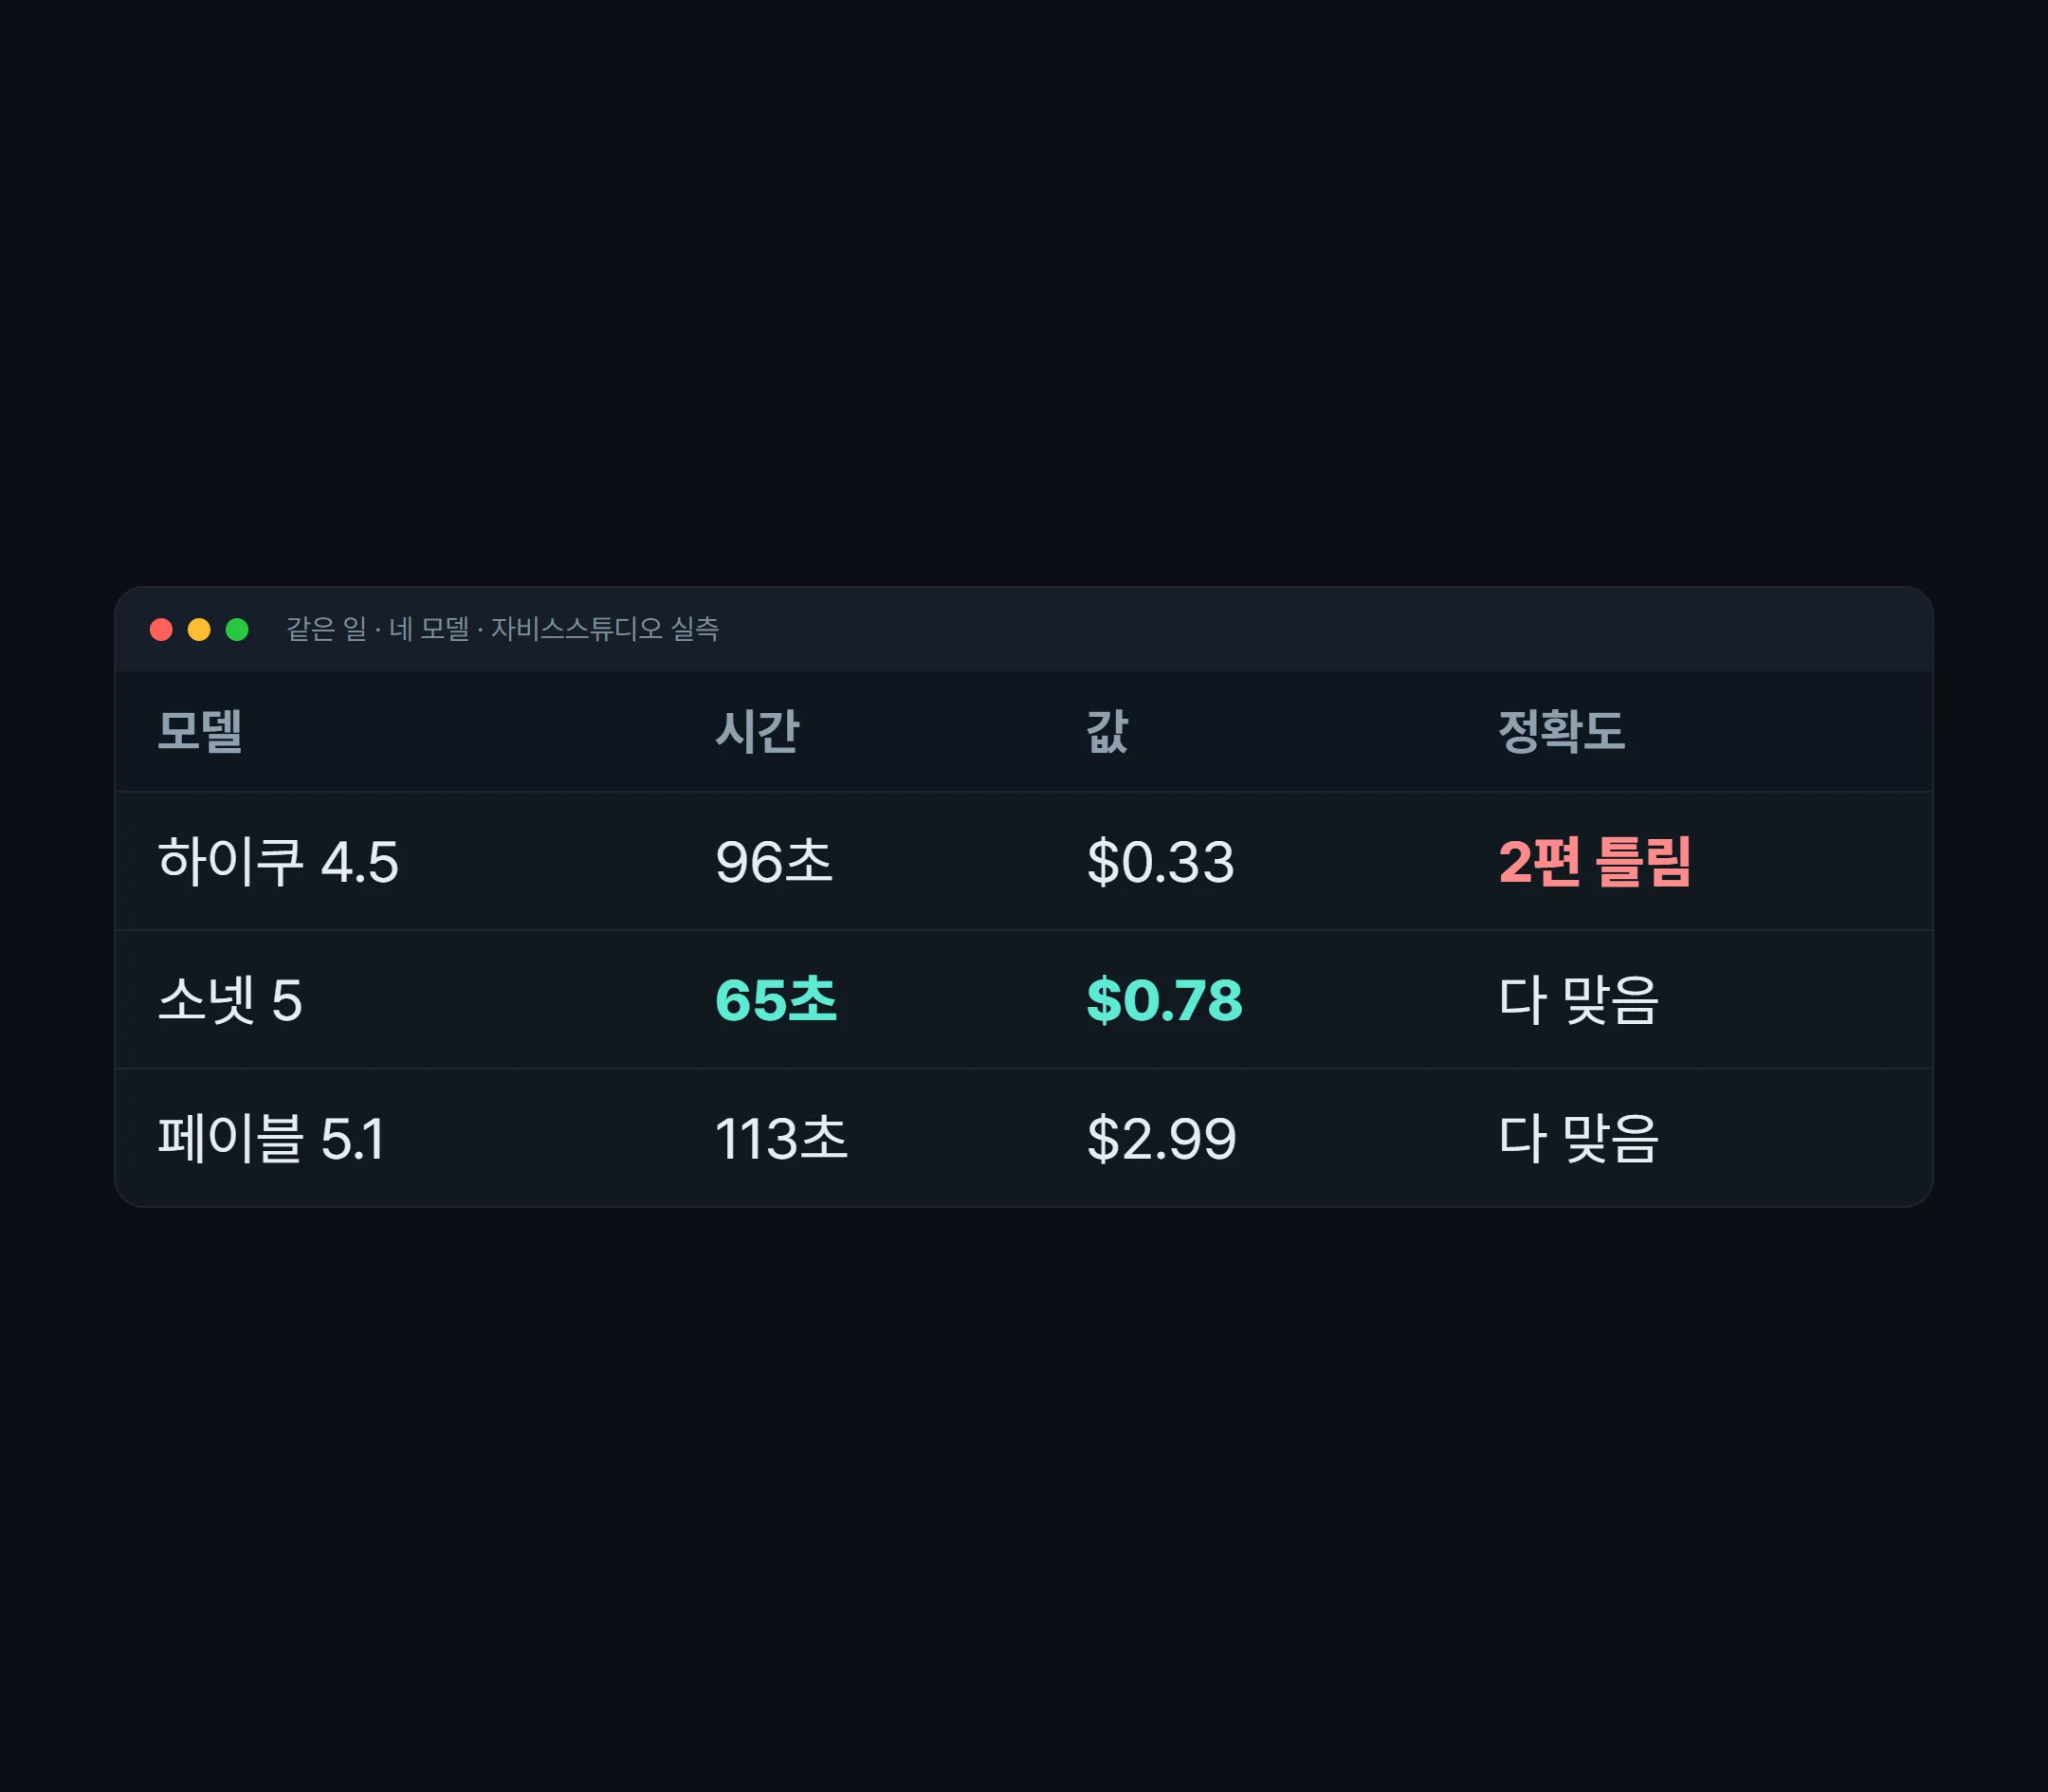
여기서 진짜 기술이 갈립니다.
싼 걸 제대로 돌리는 법 세 가지
① 정답을 먼저 만들어 둡니다
저희가 하이쿠의 오답을 잡을 수 있었던 건 정답을 스크립트로 미리 뽑아뒀기 때문입니다. 안 뽑아뒀으면 그냥 믿었을 거예요. 표가 그럴듯했거든요.
싼 모델이 위험한 게 아니라, 정답 없이 쓰는 게 위험합니다. 정답 세트 하나만 있으면 하이쿠도 쓸 자리가 생기고, 없으면 페이블도 못 믿습니다.
② 왕복을 줄입니다
모델 등급을 올리는 것보다 이게 먼저입니다. 21번 부를 걸 6번에 묶으면 값도 시간도 같이 내려갑니다. 저희 실측에서 비싼 모델이 느렸던 이유가 정확히 이거였어요.
③ 모델에게 시키는 일 자체를 줄입니다
이게 제일 크고, 제일 안 알려져 있습니다.
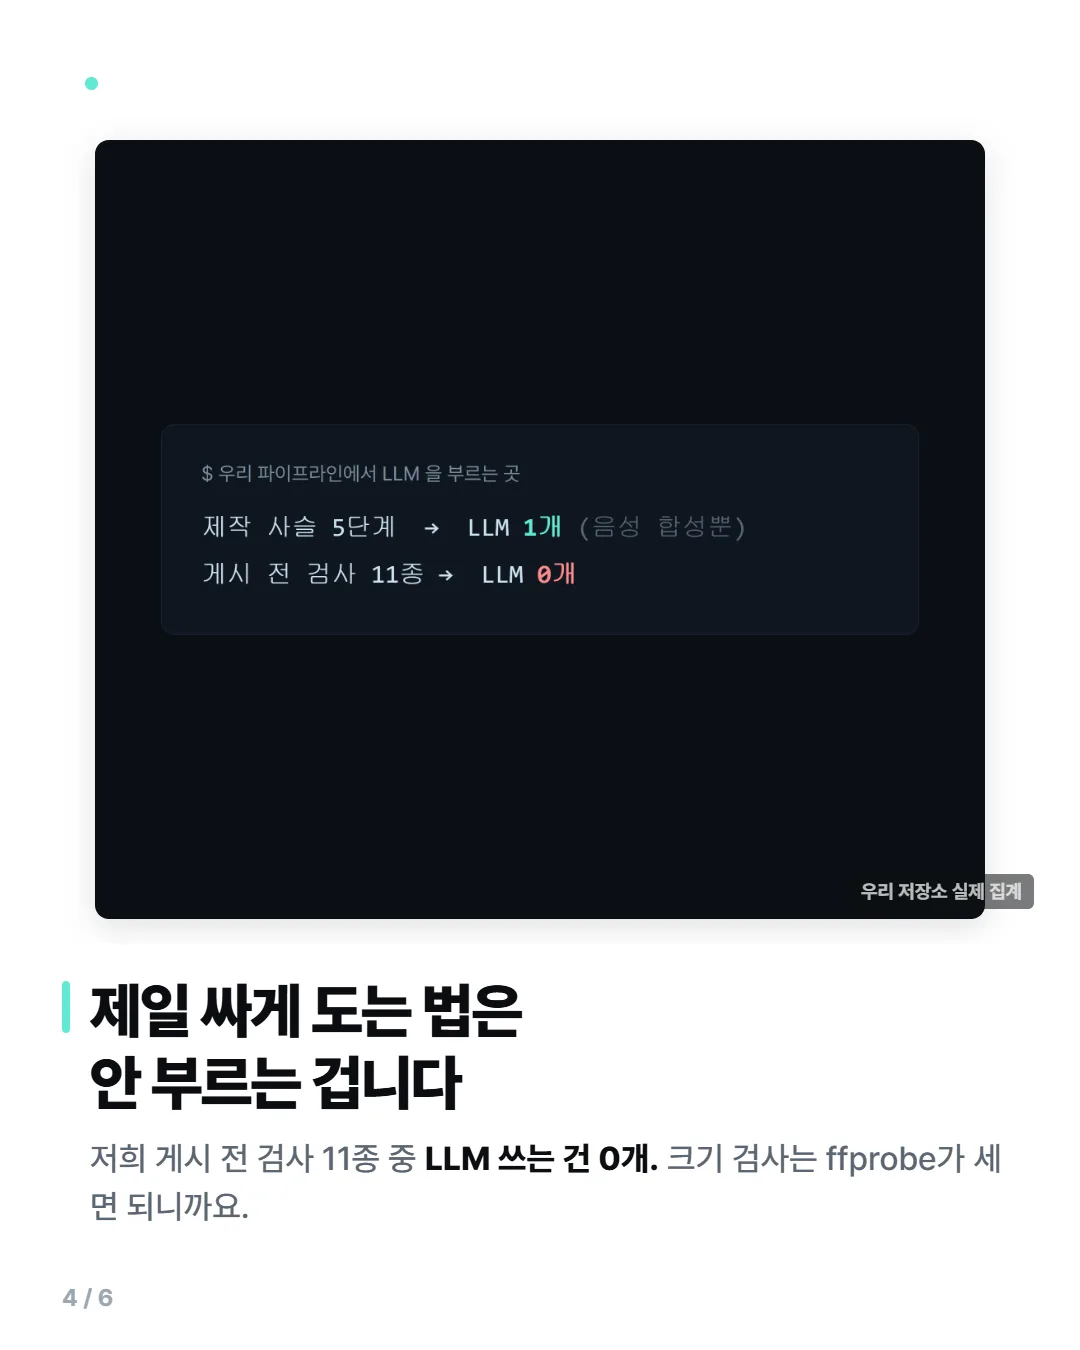
이 글을 쓰면서 저희 파이프라인을 세어봤습니다.
제작 사슬 5단계 중 LLM 호출:   1개  (음성 합성뿐)
게시 전 검사 11종 중 LLM 사용:  0개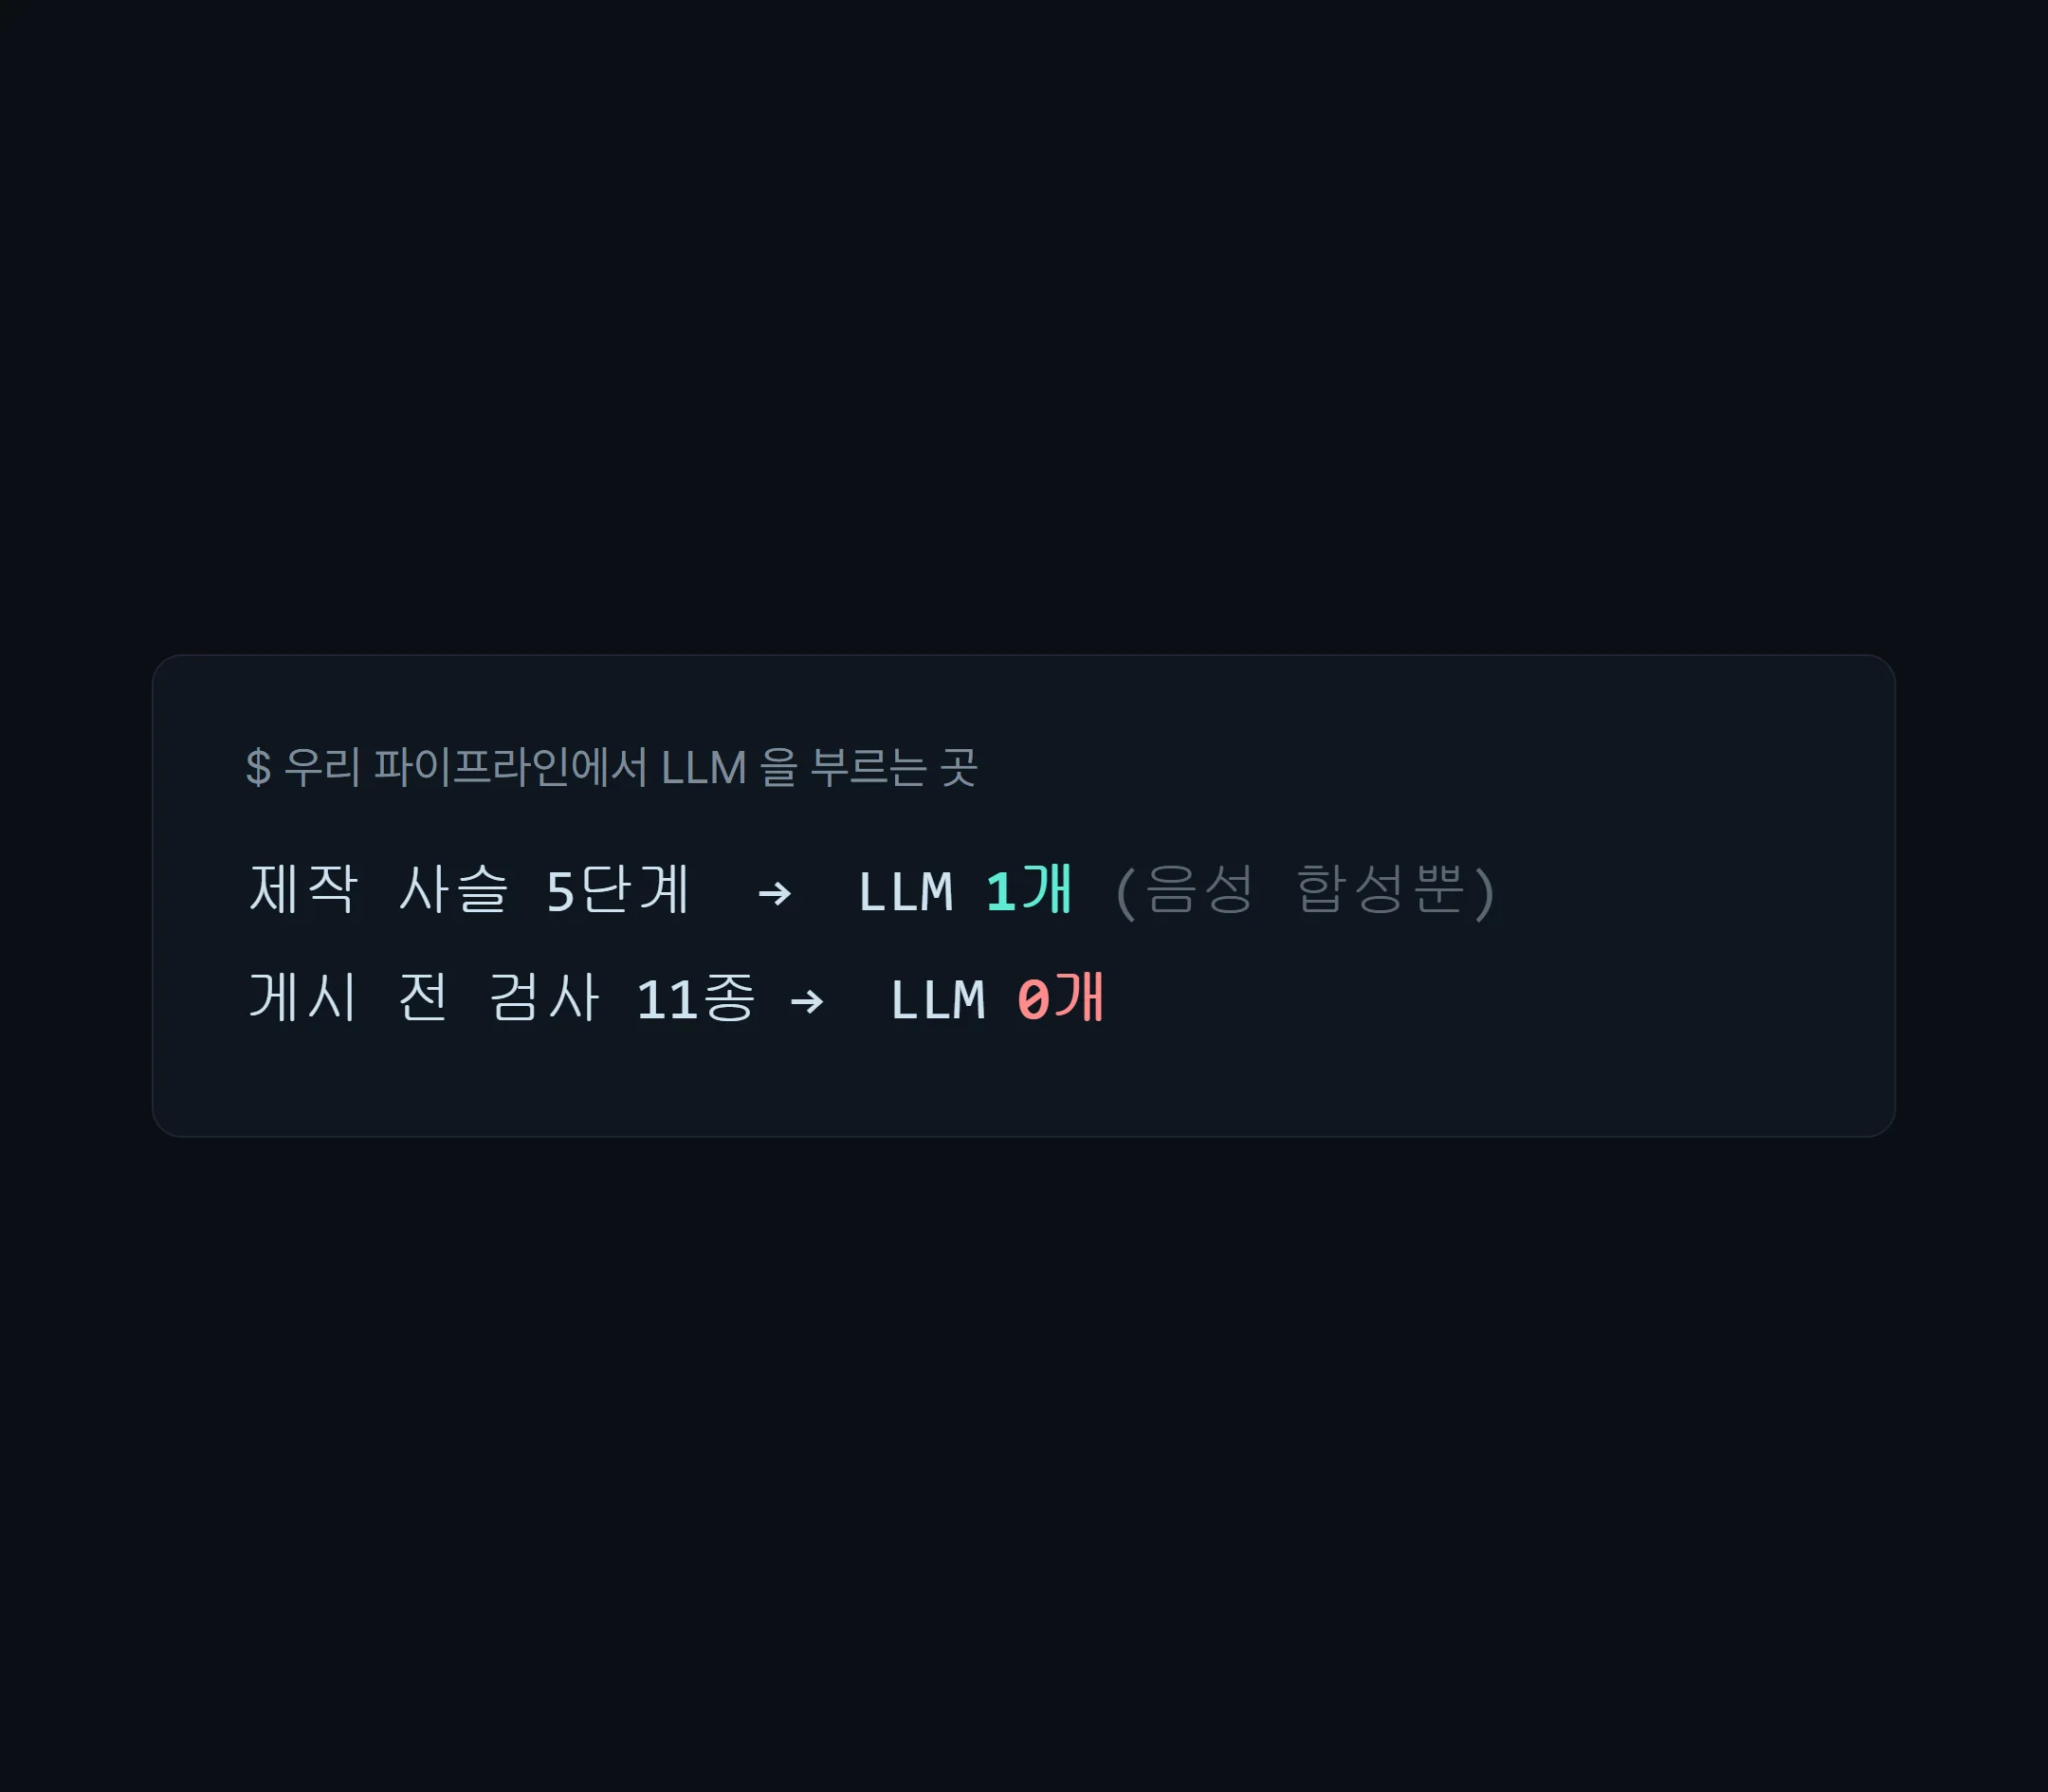
카드 만들기, webp 변환, 갤러리 삽입, 캡션 파일 생성 — 전부 스크립트가 합니다. 해시태그 검사, 공정위 고지 검사, 구독 자리 검사, 이미지 비율 검사 — 한 개도 LLM을 안 부릅니다.
"AI로 자동화한다"고 하면 다 AI가 하는 줄 아는데, 실제로는 반대입니다. AI를 쓸 자리를 좁힐수록 값도 내려가고 결과도 안정됩니다. 이미지 크기가 맞는지는 ffprobe가 세면 되지, 모델한테 물어볼 일이 아니에요.
제일 싸게 돌리는 법은, 안 부르는 것입니다.
그런데 저희 검사기를 그대로 드릴 수는 없습니다
여기까지 읽으시면 "그 검사 11종 좀 주세요"가 됩니다. 그런데 저희 검사기는 저희가 반복해서 틀린 것에서 나왔습니다. 해시태그에 #을 빼먹고, 제휴 링크도 없는 글에 공정위 고지를 붙이고, PNG를 배포에서 제외해놓고 이미지를 PNG로 넣고 — 전부 저희 실수 목록입니다.
여러분이 틀리는 지점은 다릅니다. 그러니 만드는 법을 드리는 게 맞습니다. 저희 11종이 다 이 네 단계로 나왔습니다.
① "내가 매번 눈으로 확인하는 것"을 적는다
그게 검사기 후보입니다. 새로 상상하지 마세요. 발행 직전에 마우스를 멈추고 확인하는 그것, 한 번 틀려서 다시 올렸던 그것.
저희는 해시태그 #이 빠진 채로 5편 35개가 나간 걸 뒤늦게 발견하고 check-blog-tags를 만들었습니다. 검사기는 사고 뒤에 생깁니다.
② 기계가 셀 수 있는 문장으로 바꾼다
여기가 갈림길입니다.
| 못 세는 것 (사람 몫) | 세는 것 (검사기 몫) |
|---|---|
| 제목이 끌리나 | 제목이 32자를 넘나 |
| 이미지가 어울리나 | 선언한 비율이 실제와 1% 넘게 다른가 |
| 글이 설득되나 | 구독 링크가 본문과 하단에 다 있나 |
못 세는 건 사람 몫으로 남깁니다. 여기에 LLM을 넣고 싶어지는데, 그게 값이 새는 자리예요. 판단이 필요하면 사람이, 정답이 정해져 있으면 스크립트가 합니다. LLM은 그 사이의 좁은 자리입니다.
③ 종료코드로 말하게 한다
화면에 예쁘게 출력하는 건 소용없습니다. 오류면 1, 통과면 0으로 끝나야 파이프라인이 멈춥니다.
// check-mine.mjs — 검사기 한 개의 최소 뼈대
import fs from "node:fs";
const dir = process.argv[2];
const errors = [], warns = [];

// ① 사실을 잰다 — 눈이 아니라 파일에서
const html = fs.readFileSync(`${dir}/index.html`, "utf8");
const imgs = [...html.matchAll(/<img[^>]*>/g)].map((m) => m[0]);

// ② 규칙을 건다
for (const tag of imgs) {
  if (!/width=/.test(tag) || !/height=/.test(tag))
    errors.push(`크기 없는 img: ${tag.slice(0, 60)}`);
}
if (!/newsletter/.test(html)) warns.push("구독 링크가 없습니다");

// ③ 종료코드로 말한다
errors.forEach((e) => console.log("  [오류]", e));
warns.forEach((w) => console.log("  [경고]", w));
process.exit(errors.length ? 1 : 0);
30줄이면 첫 검사기가 됩니다. 경고와 오류를 나누는 게 핵심이에요. 전부 오류로 만들면 통과하는 글이 없어서 결국 검사기를 끄게 됩니다. 저희도 스레드 검사를 엄격하게 걸었더니 64편 중 4편만 통과해서, 오류(링크 아예 없음)만 막고 나머지는 경고로 내렸습니다.
④ 게이트에 물린다 — 이게 없으면 앞의 셋이 무효입니다
node check-mine.mjs ./post || exit 1 # 하나라도 오류면 발행이 멈춘다문서에만 있는 규칙은 반드시 어긋납니다. 저희는 "대가를 안 받는 글엔 공정위 고지를 넣지 않는다"를 문서에 적어두고 있었는데, 실제로 세어보니 제휴 링크가 하나도 없는 글 2편과 캡션 1건에 고지가 붙어 있었습니다. 없는데 붙이는 것도 위반입니다. 검사기를 만들어 돌리기 전까지 아무도 몰랐어요.
규칙을 지키는 건 의지가 아니라 종료코드 1입니다.
그러면서도 저희는 이걸 못 고쳤습니다
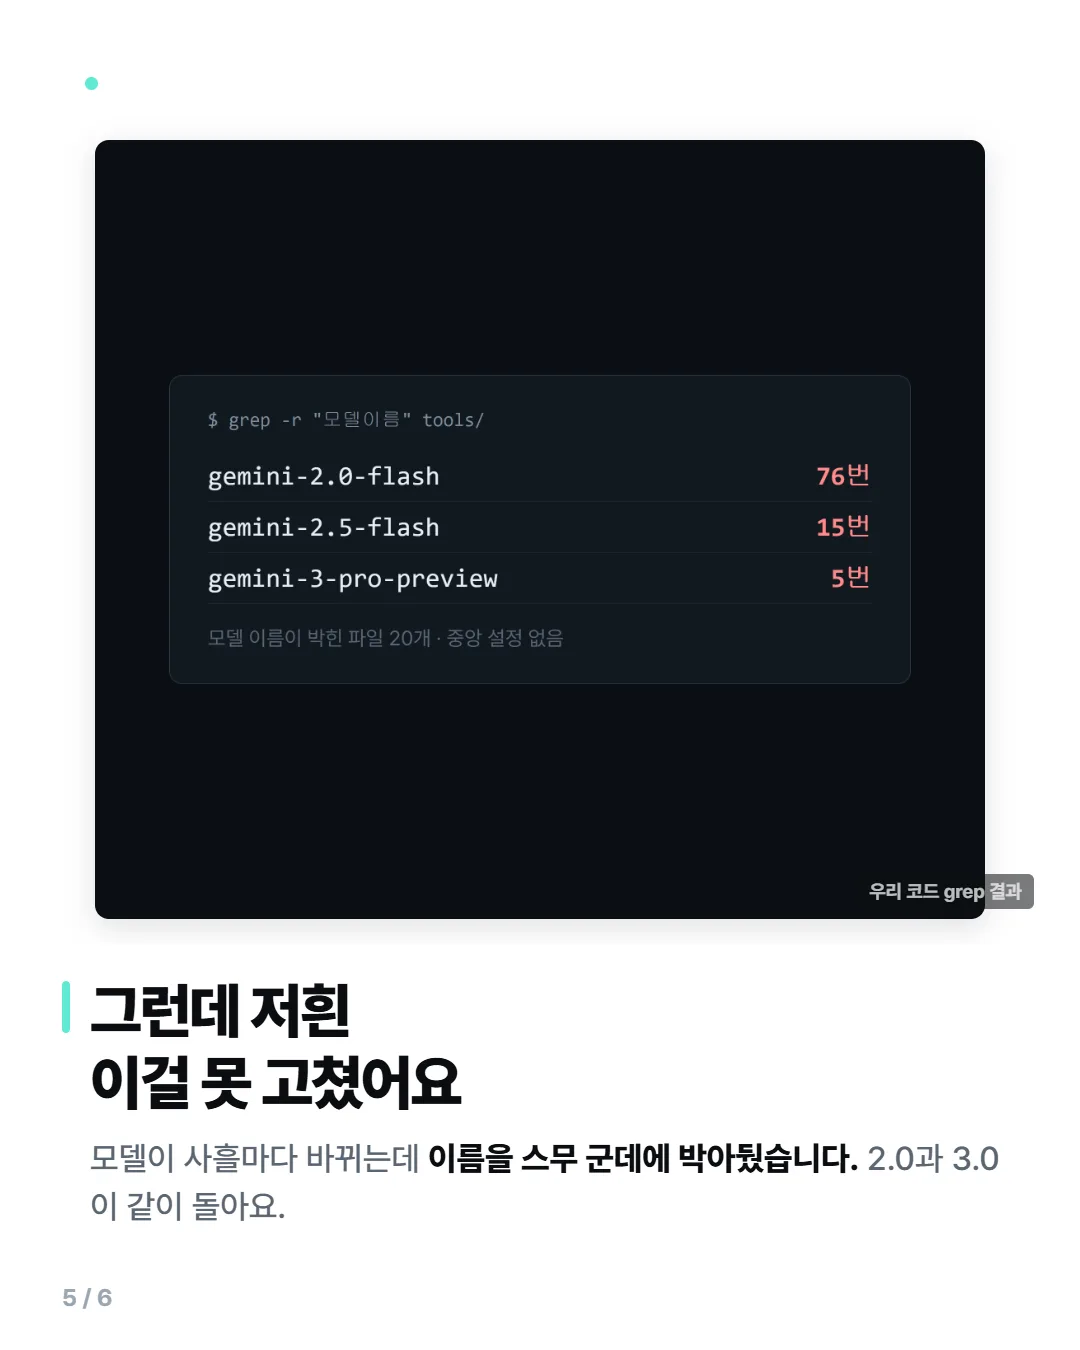
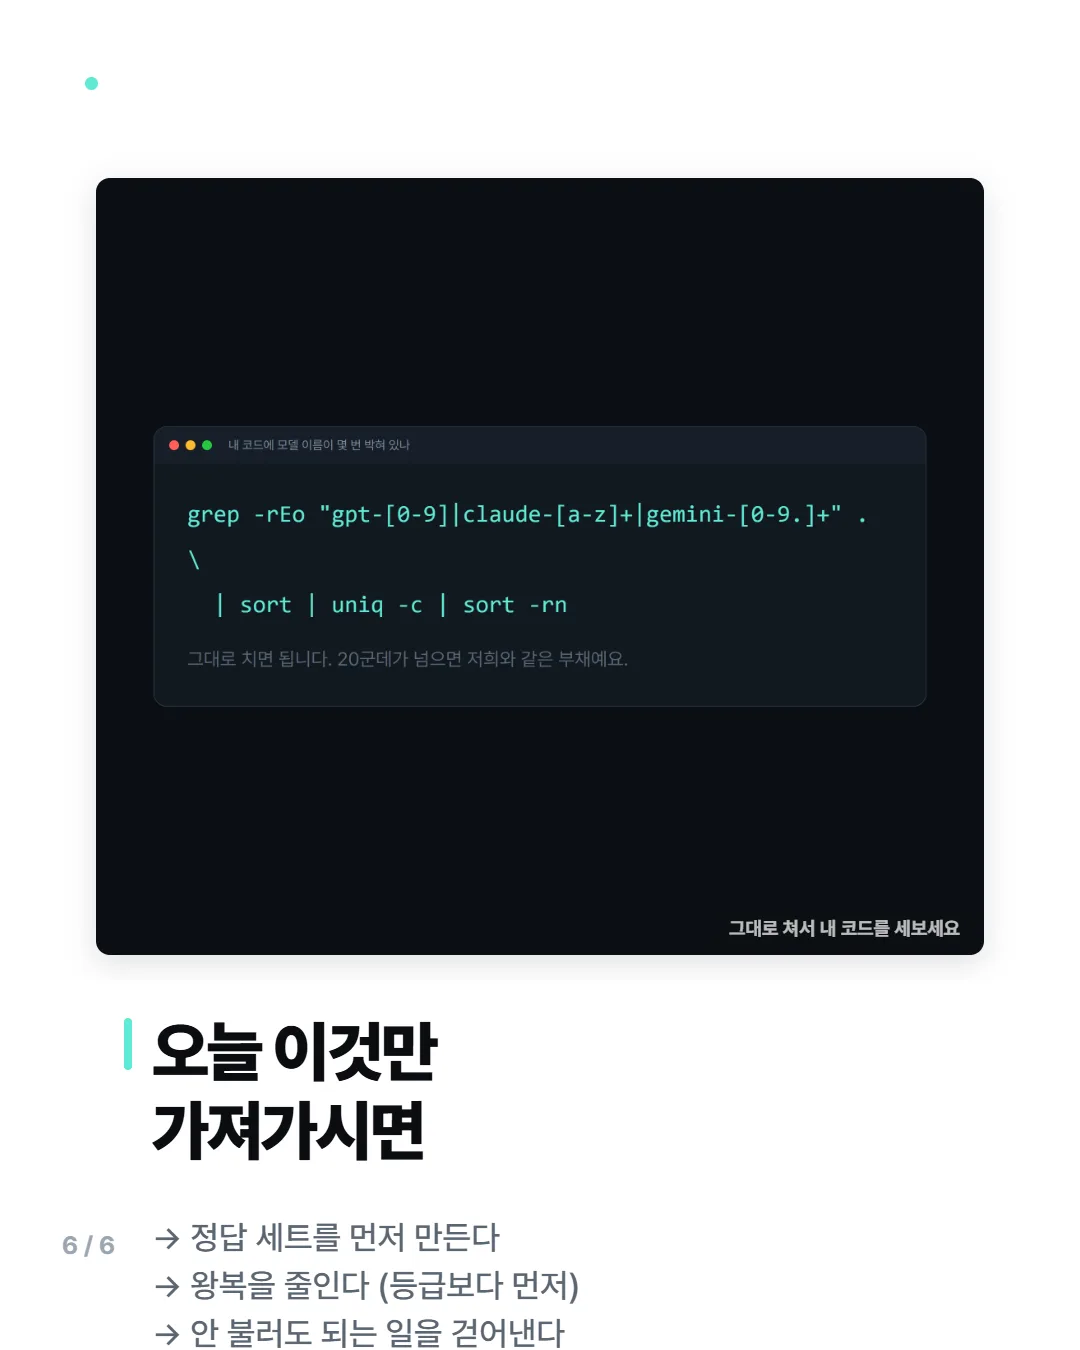
같은 김에 저희 코드를 grep 해봤어요.
gemini-2.0-flash          76번
gemini-2.5-flash          15번
gemini-3-pro-preview       5번

모델 이름이 박힌 파일: 20개 · 중앙 설정: 없음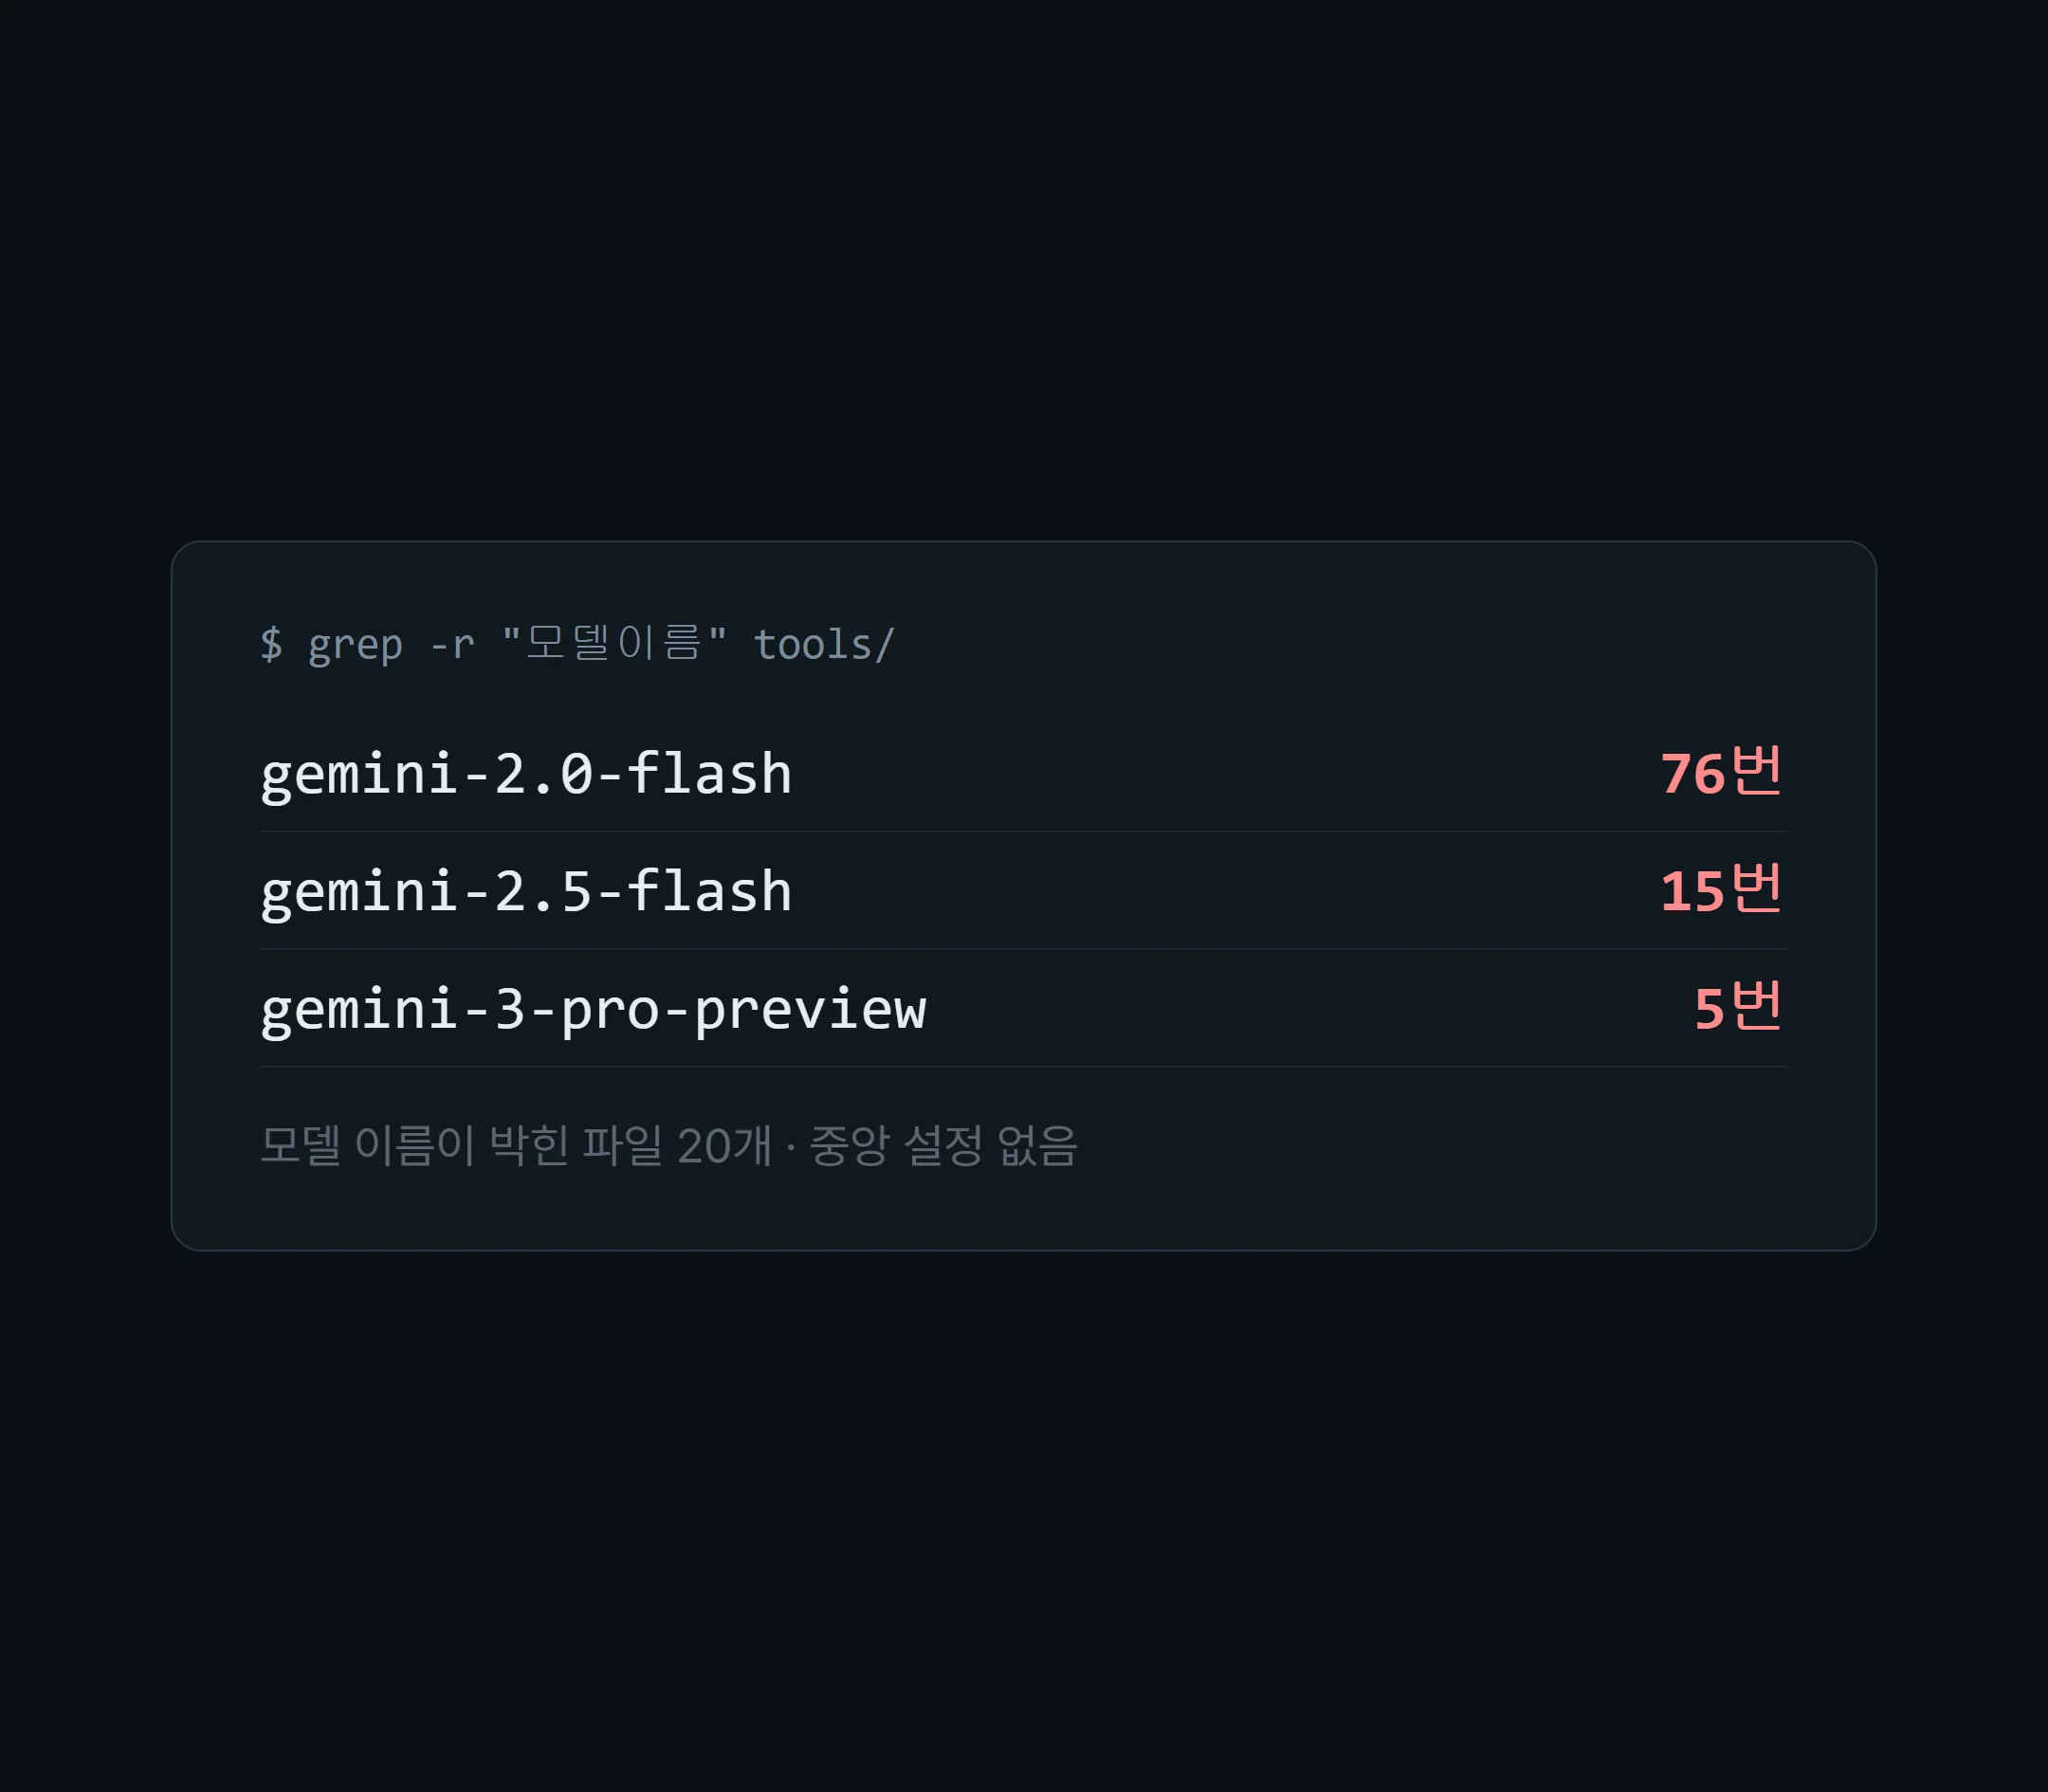
모델이 사흘마다 바뀌는데 이름을 스무 군데에 박아뒀습니다. 2.0과 3.0이 같은 저장소에서 같이 돌고 있어요.
다음에 값이 또 내려가도 저희는 그 이득을 못 가져갑니다. 스무 군데를 고쳐야 하니까요. 이건 부채입니다.
그래서 내린 결론
새 모델이 나오면 갈아타는 게 아니라, 갈아탈 수 있는 구조를 먼저 만드는 것.
- 모델을 이름이 아니라 역할로 부른다 —
싼것·정확한것·긴것 - 왕복을 줄인다 — 등급 올리기보다 먼저다
- 안 불러도 되는 일을 계속 걷어낸다 — 스크립트가 세면 되는 건 스크립트가
값이 내려가는 흐름에서 이득을 가져가는 쪽은 제일 센 모델을 쓰는 사람이 아니라, 갈아끼우기 쉬운 구조를 가진 사람입니다.
저희도 아직 못 고쳤습니다. 다음 편에서 스무 군데를 한 곳으로 모으는 걸 하겠습니다.
오늘 이것만
- 경쟁 축이 점수에서 성능÷값으로 옮겨갔습니다. 좋은 모델은 계속 싸집니다.
- 비싼 모델이 빠른 게 아닙니다. 저희 실측에서 제일 비싼 게 제일 느렸습니다.
- 싼 걸 제대로 돌리려면 정답 세트 · 왕복 줄이기 · 안 부르기 셋입니다.
- 저희 검사기를 드릴 순 없습니다. 대신 내가 매번 눈으로 보던 것 → 셀 수 있는 문장 → 종료코드 → 게이트 네 단계면 첫 검사기가 나옵니다.
- 새 모델이 나오면 갈아타지 말고, 갈아탈 수 있는 구조를 먼저 만드세요.
돈 안 드는 쪽이 궁금하시면 GPU 없이 로컬 AI 4종을 실측한 글도 있습니다.